


A Anthropic anunciou uma expansão do seu Cyber Verification Program, o CVP, para liberar recursos avançados de claude ia segurança a profissionais verificados de cibersegurança. A mudança importa porque tenta resolver um impasse central da IA aplicada à defesa digital: os mesmos modelos capazes de encontrar falhas antes dos criminosos também podem ajudar em abuso se forem usados sem controle.
Segundo a empresa, o programa passa a reunir três níveis de acesso, com requisitos e travas diferentes. A ideia é permitir que defensores legítimos usem modelos mais capazes, como Claude Opus 5.5, Claude Sonnet 5.5 e Claude Mythos 5.1, sem abrir a porta para operações ofensivas não autorizadas. A notícia foi publicada pela Anthropic em 6 de outubro de 2026.
O tema também conversa com uma discussão recorrente no setor: até onde empresas de IA devem bloquear usos sensíveis quando o mesmo pedido pode ser legítimo em uma equipe de resposta a incidentes, mas perigoso nas mãos erradas. No GalaxyIA, já mostramos como a segurança da OpenAI virou alvo de debate parecido.
Como funciona o Claude IA segurança no CVP
O primeiro nível é o Defense Access, voltado a trabalho defensivo. Ele cobre tarefas como operação de centros de segurança, resposta a incidentes, engenharia reversa de malware e análise ou validação de vulnerabilidades. A Anthropic diz esperar que muitas organizações defensivas se qualifiquem para essa faixa, incluindo empresas, universidades, governos, mantenedores de código aberto e pesquisadores individuais com histórico de divulgação responsável.
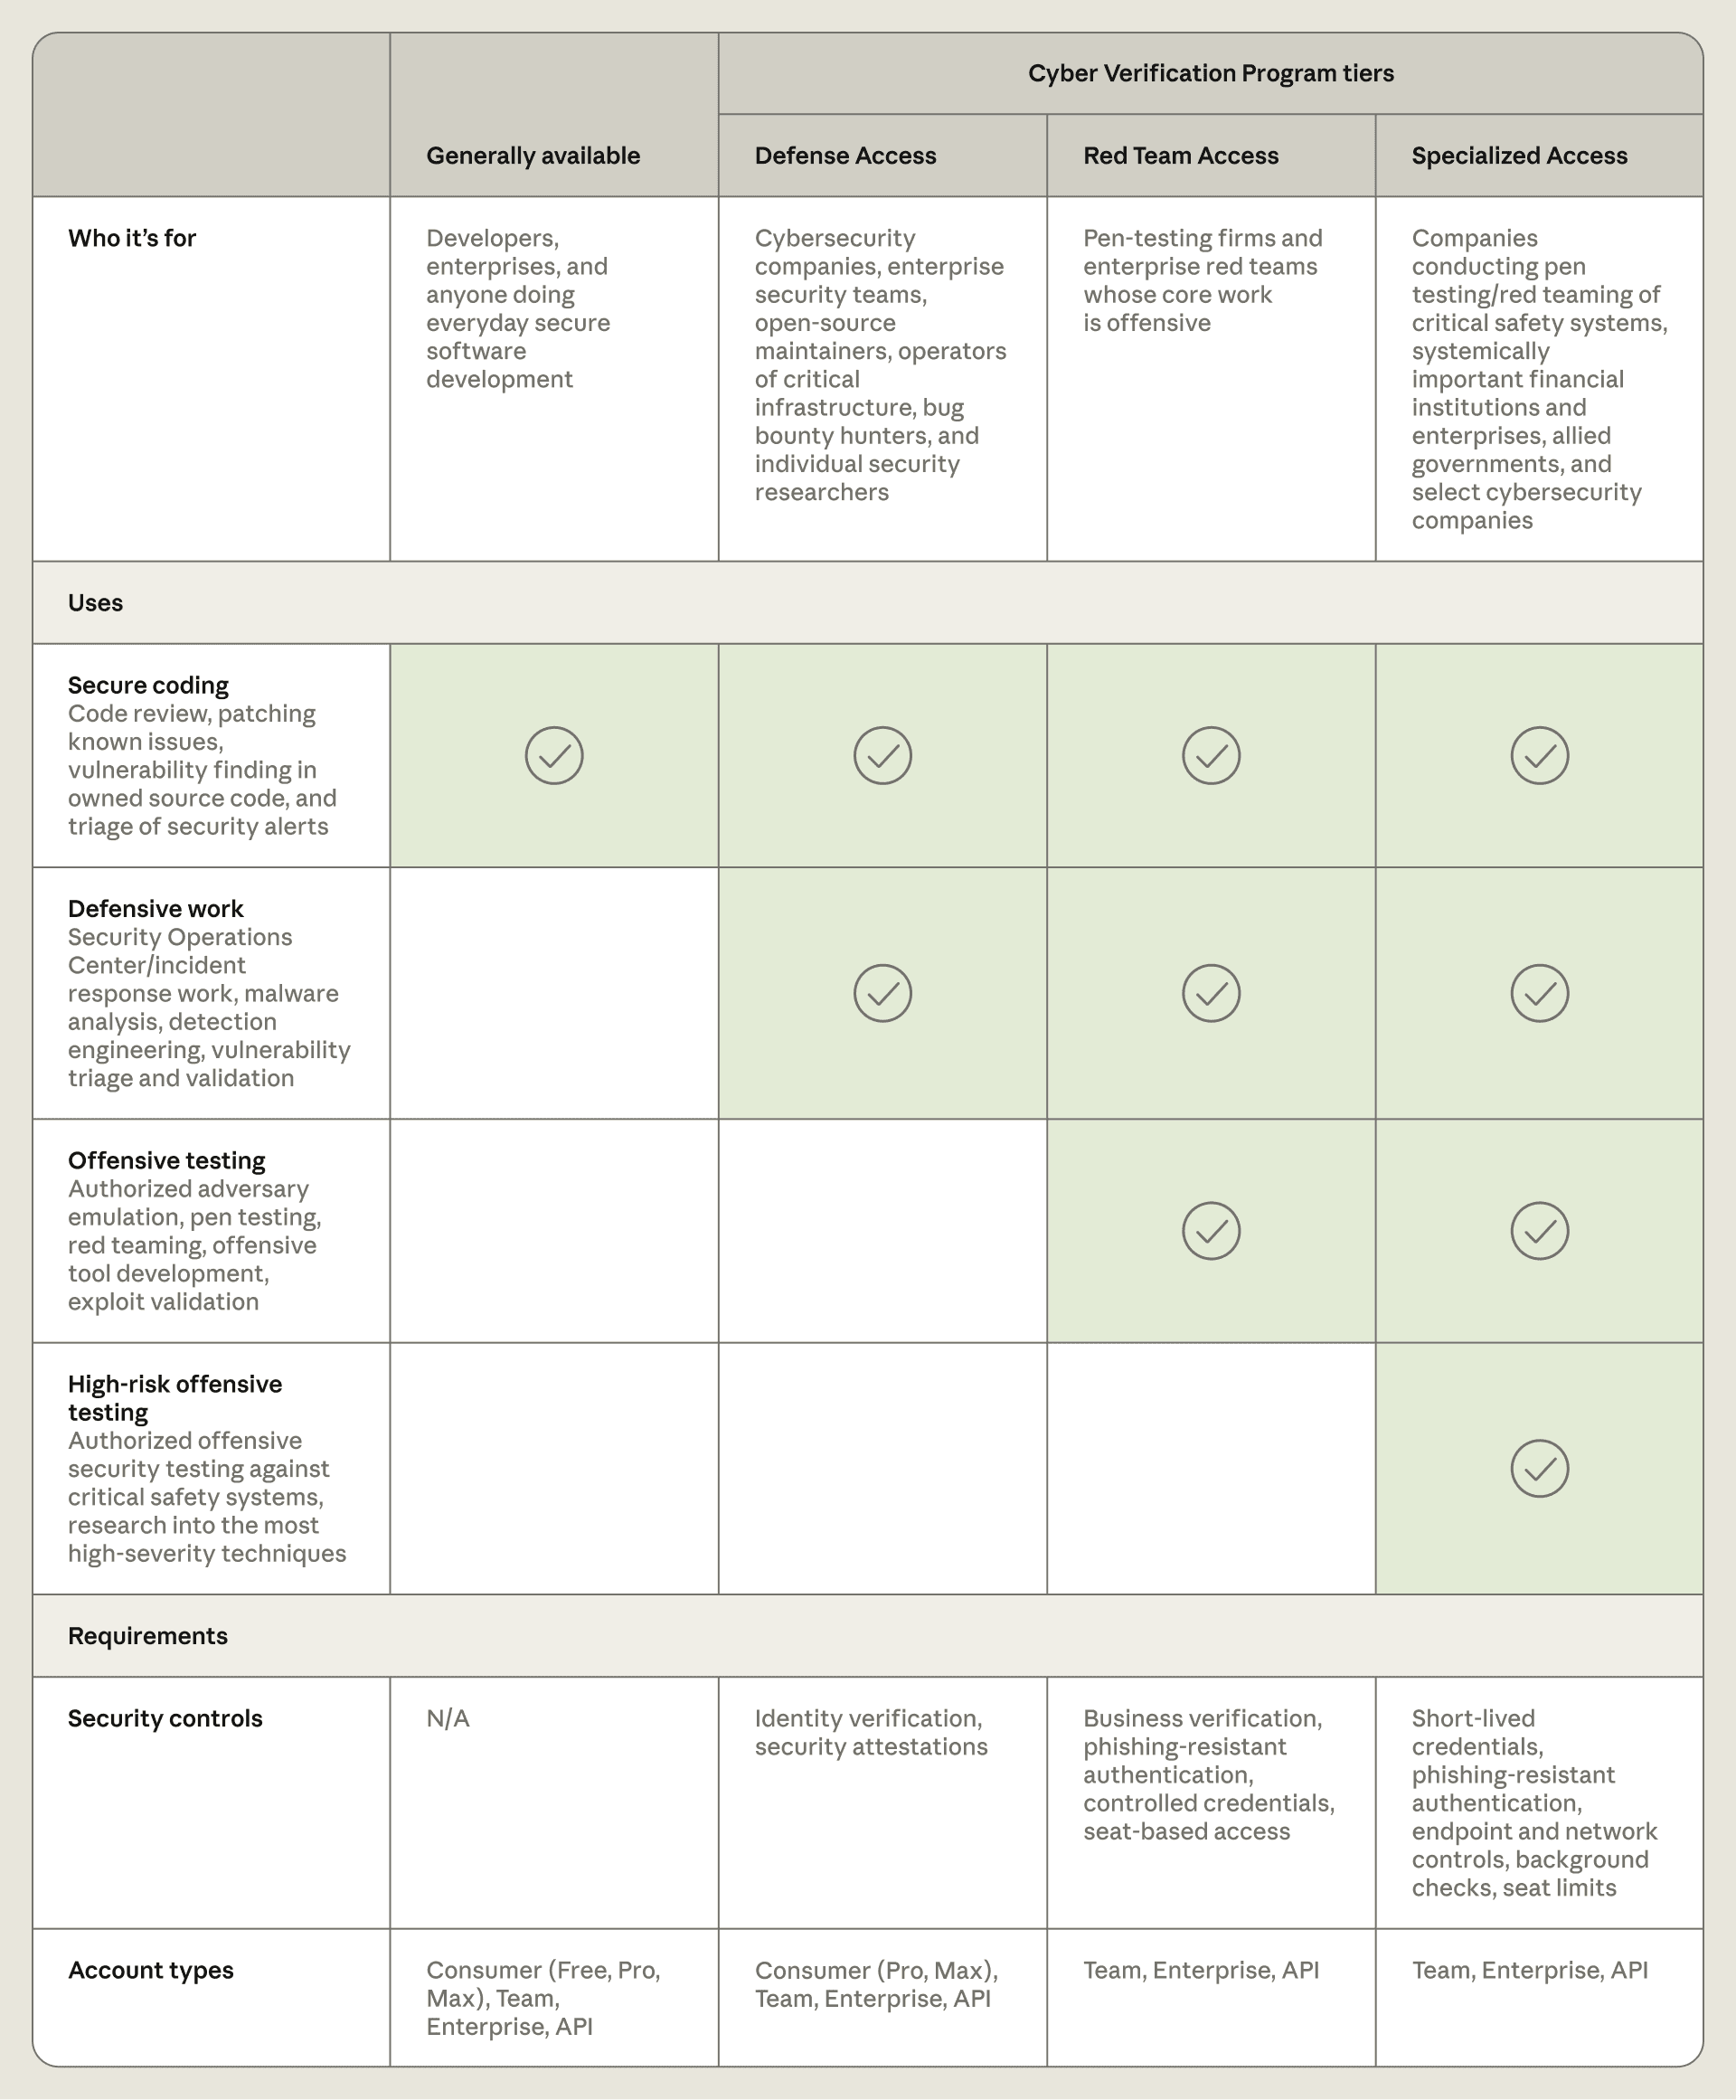
O segundo nível é o Red Team Access. Ele adiciona testes de invasão autorizados e exercícios de red team, mas apenas contra sistemas que a organização tem permissão para testar. A empresa afirma que esse acesso ainda mantém bloqueios em tempo real contra ações com potencial de dano físico ou interrupção em massa, como ransomware, danos a sistemas físicos ou testes em sistemas de segurança de alto risco.
O terceiro é o Specialized Access, reservado a um grupo menor de organizações verificadas. É a camada com menos bloqueios cyber e será usada para testes autorizados em sistemas que podem afetar vidas humanas ou mercados, como redes elétricas, telecomunicações, infraestrutura bancária, sistemas de voo e redes administrativas governamentais. De acordo com a Anthropic, a revisão desse nível envolve análise aprofundada em colaboração com o governo dos Estados Unidos.
O que os testes da Anthropic mostram
Para avaliar se os níveis funcionam como esperado, a Anthropic testou o Claude Opus 5.5 no CyScenarioBench, uma avaliação voltada a operações cyber de múltiplas etapas. A empresa afirma que, sem acesso CVP, todas as tarefas foram bloqueadas no primeiro prompt. No Defense Access, 46 de 50 tentativas foram bloqueadas em algum ponto do desafio, enquanto quatro tiveram sucesso.
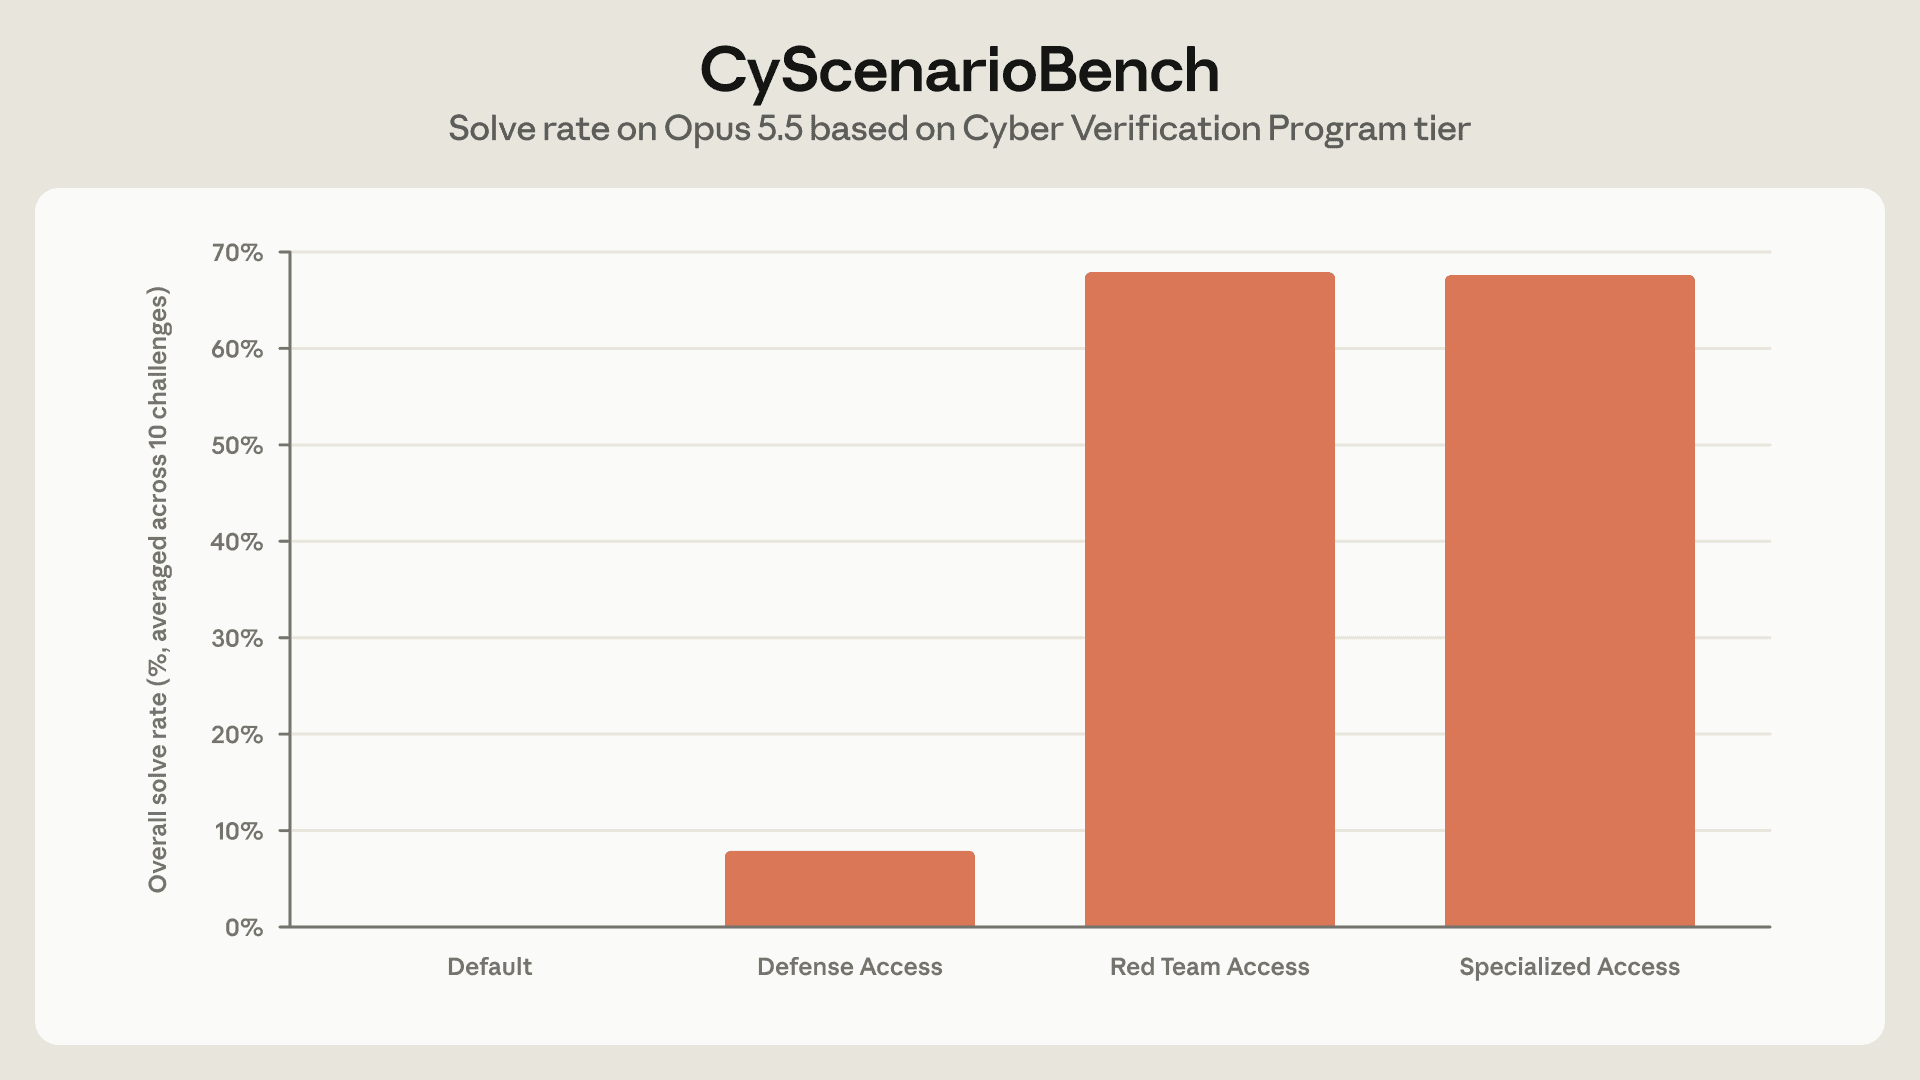
No Red Team Access, a Anthropic diz que não houve bloqueios e que o Claude Opus 5.5 completou 34 de 50 tarefas, taxa que a empresa considera equivalente ao desempenho do modelo sem salvaguardas aplicadas. O resultado indica que a camada intermediária foi desenhada para permitir testes ofensivos autorizados sem levar o mesmo nível de liberdade para usuários gerais ou para o acesso defensivo mais amplo.
O ponto sensível está na governança. A empresa exige verificação dos solicitantes e prova dos controles de segurança necessários para cada nível. Também prevê retenção de dados para monitorar mau uso, embora diga que uma solução chamada Enterprise Frontier Safeguards deve permitir, mais adiante, que organizações elegíveis mantenham os dados em infraestrutura de nuvem sob seu próprio controle.
Project Glasswing virou base da expansão
O anúncio não começa do zero. A Anthropic afirma que o CVP ampliado incorpora aprendizados do Project Glasswing, programa que deu acesso a modelos Claude Mythos para organizações envolvidas na proteção de software crítico. Segundo a empresa, parceiros do projeto identificaram ao menos 129 mil vulnerabilidades verificadas entre abril e julho de 2026. A Anthropic também diz ter encontrado mais 5,5 mil vulnerabilidades em varreduras de código aberto entre abril e outubro.
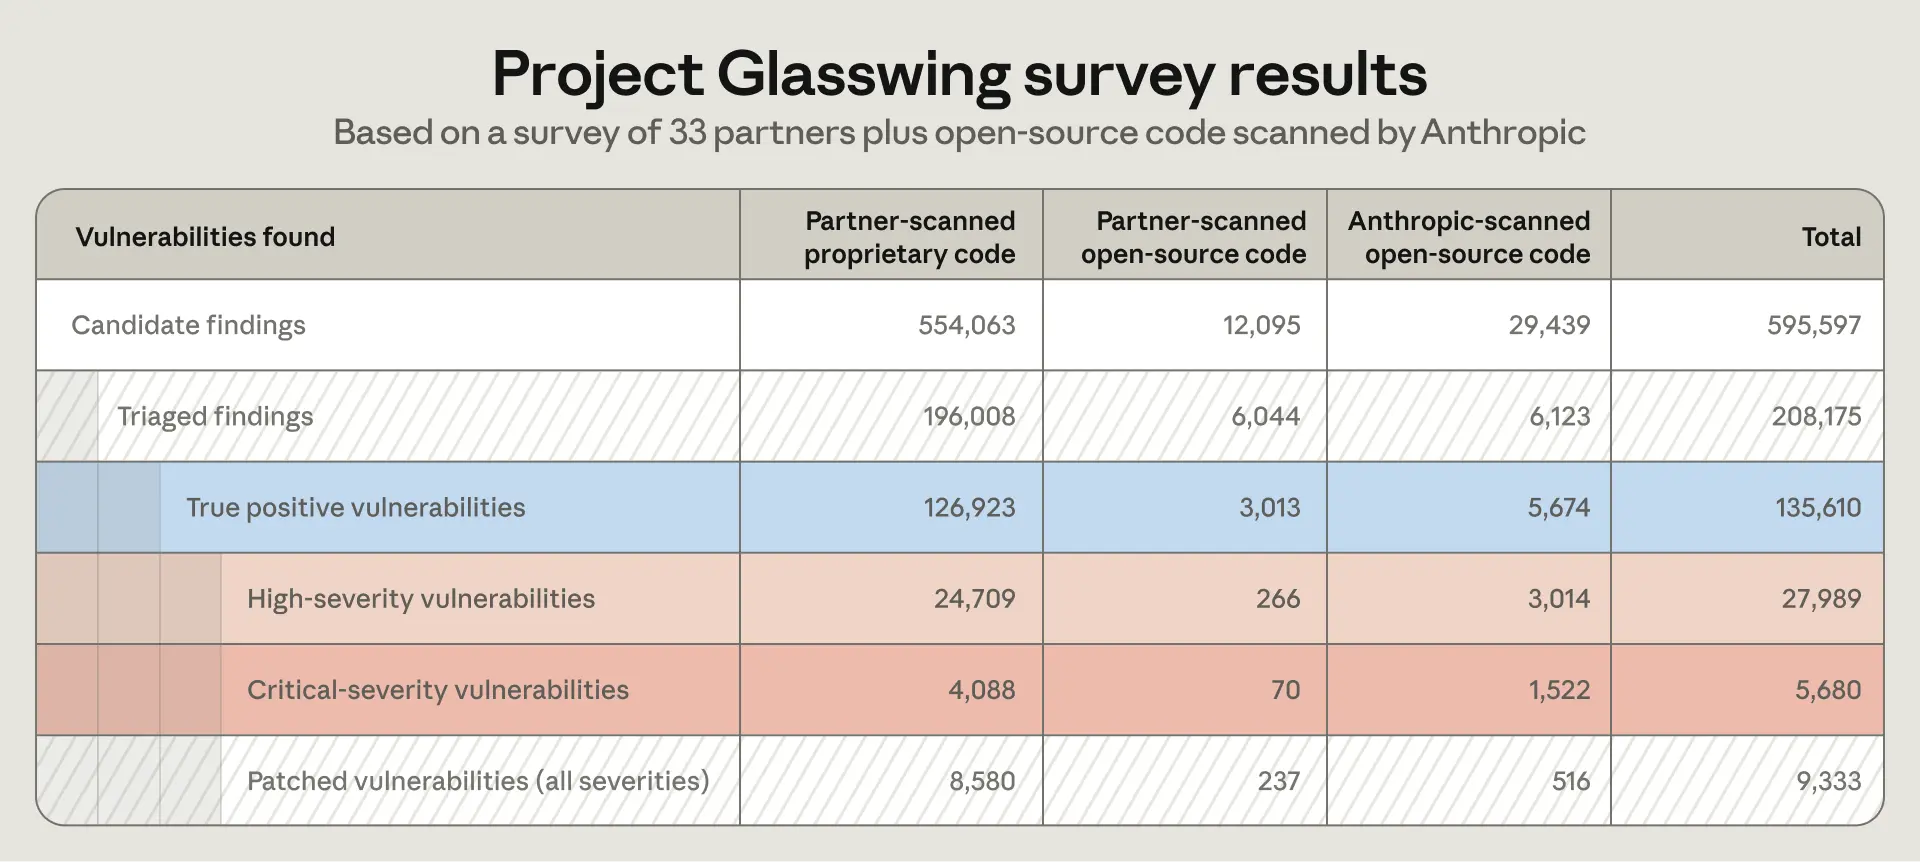
Mais de 33 mil dessas falhas foram classificadas até agora como críticas ou de alta severidade, mas a própria empresa avisa que o número pode estar subestimado, porque parte dos dados vem de relatórios de apenas um subconjunto dos parceiros. Em outra publicação, a Claude relatou casos de Comcast e Booz Allen usando modelos Mythos para encontrar cadeias de exploração e falhas que scanners tradicionais poderiam deixar passar.
Por que isso importa para empresas brasileiras
Para organizações no Brasil, a novidade não significa acesso irrestrito a capacidades ofensivas. O recado prático é outro: fornecedores de IA estão começando a separar usos cyber por identidade, finalidade e controle, em vez de tratar todos os pedidos sensíveis do mesmo modo. Isso pode beneficiar times maduros de segurança, mas também aumenta a responsabilidade sobre auditoria, autorização formal de testes e validação humana dos achados.
Há ainda um risco de expectativa. Modelos como Claude podem acelerar triagem, revisão de código e investigação de cadeias de falhas, mas o anúncio da Anthropic insiste que eles operam dentro de níveis de acesso e que as equipes continuam responsáveis por validar, corrigir e monitorar os sistemas. Em cibersegurança, uma descoberta gerada por IA só vira proteção real quando alguém confirma o impacto, prioriza o reparo e acompanha se a correção funcionou.
Fontes:

Deixe um comentário