


O Google DeepMind lançou o EmbeddingGemma 2, um modelo aberto de embeddings multimodais pensado para rodar diretamente em celulares, computadores e outros dispositivos locais. A novidade importa porque transforma texto, código, imagem, vídeo e áudio em uma mesma representação numérica, o que facilita buscas semânticas, recuperação de informações e agentes de IA sem depender necessariamente de enviar todos os dados para a nuvem.
Segundo o anúncio oficial, o modelo tem 740 milhões de parâmetros, usa a arquitetura Gemma 4 e foi publicado sob licença Apache 2.0. A proposta é ocupar um espaço que cresceu rápido desde o primeiro EmbeddingGemma: busca local, RAG privado e organização inteligente de arquivos em apps de consumo.
O que o EmbeddingGemma 2 faz
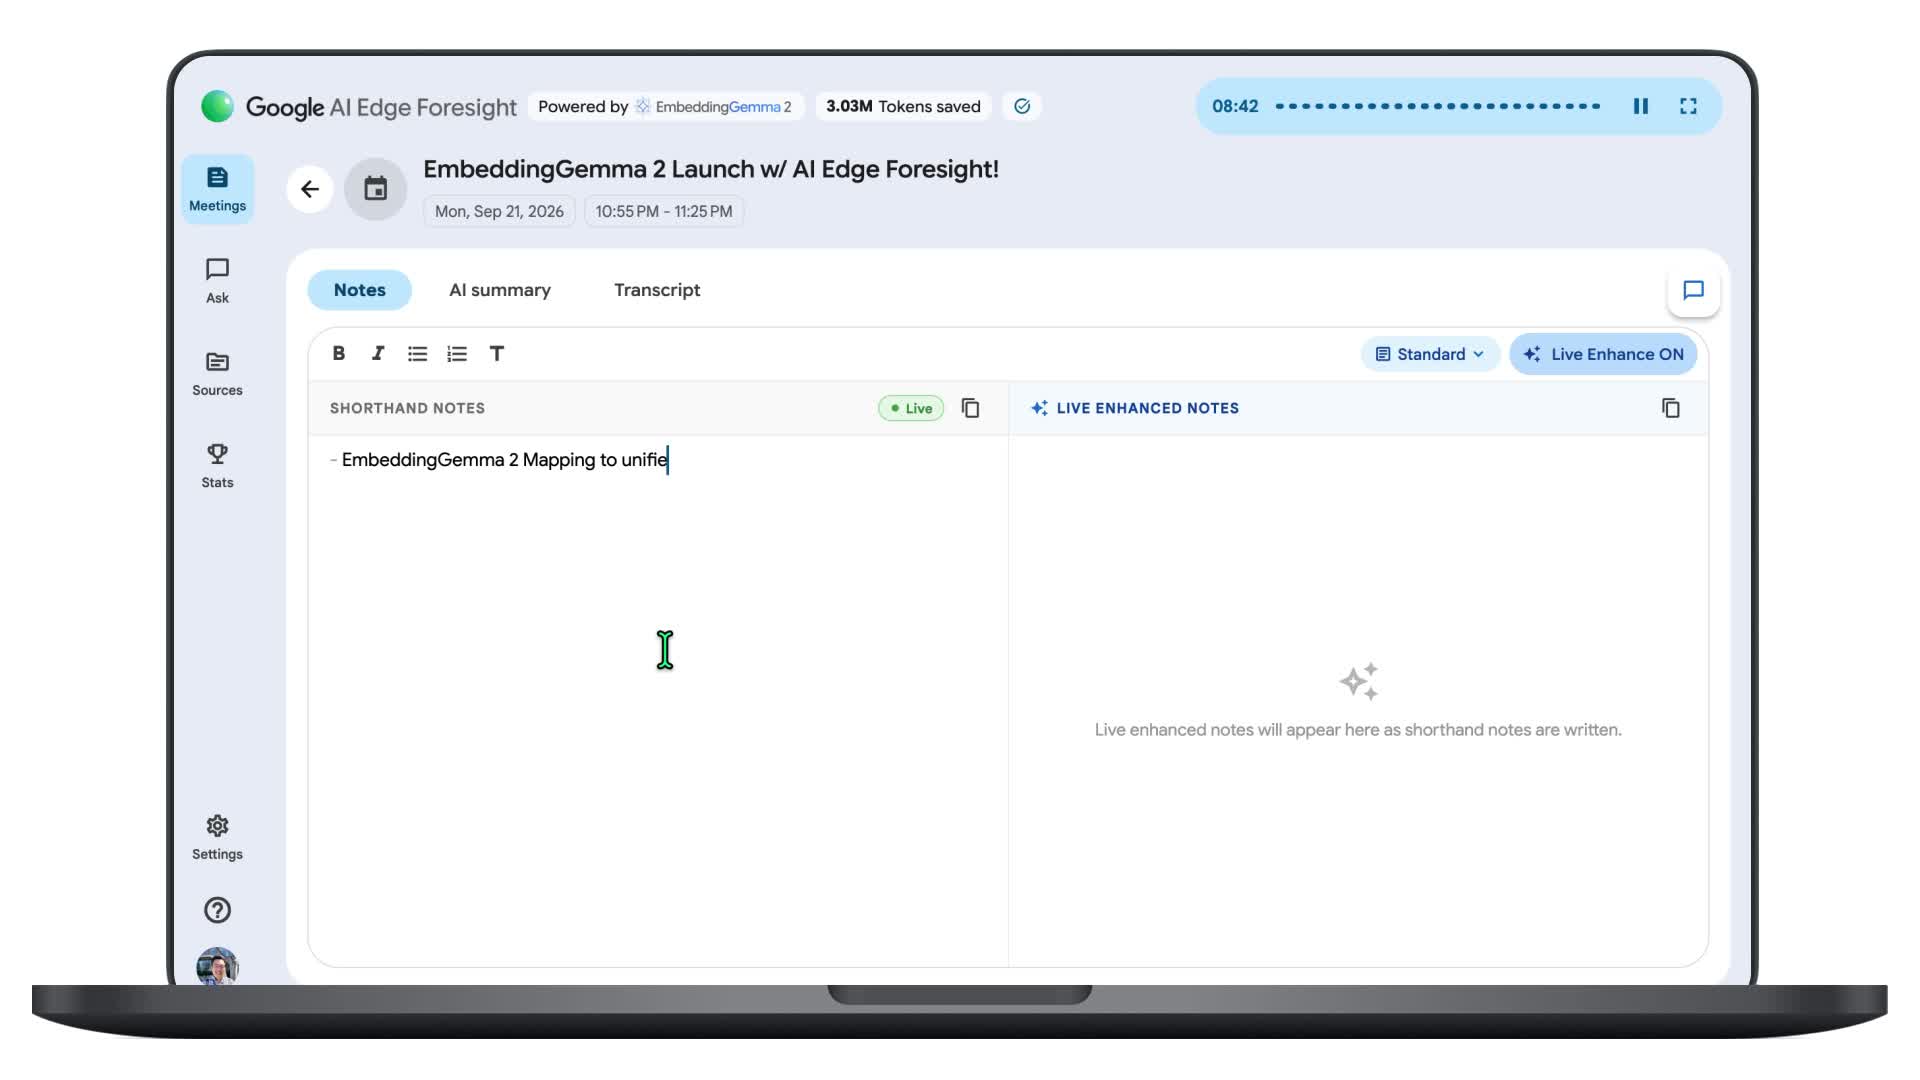
Embeddings são vetores que permitem comparar conteúdos por significado, não apenas por palavras iguais. Em vez de procurar somente pelo nome de um arquivo, um app pode entender que uma foto, um trecho de áudio e uma frase digitada pelo usuário apontam para o mesmo contexto. É esse tipo de ponte que o EmbeddingGemma 2 tenta colocar dentro do dispositivo.
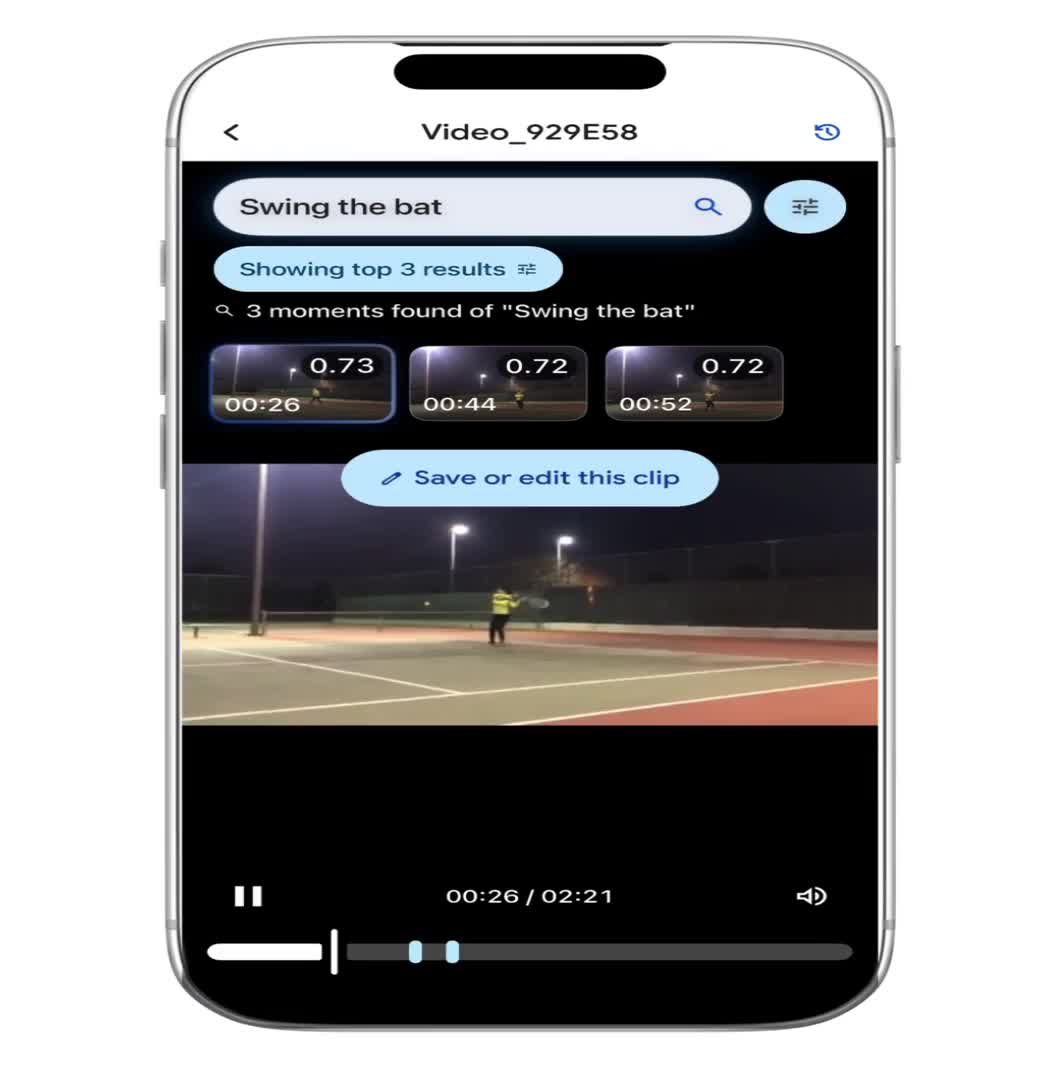
O Google afirma que o modelo unifica código, imagens, vídeo e áudio em um espaço compartilhado. Na prática, isso permite casos como encontrar um trecho específico de vídeo a partir de uma anotação de voz, buscar horas de gravações com uma pergunta em texto ou indexar uma base de código para um agente de programação. A companhia também diz que o modelo mantém a força multilíngue do EmbeddingGemma anterior e melhora o desempenho em código.
Modelo menor, uso local e privacidade
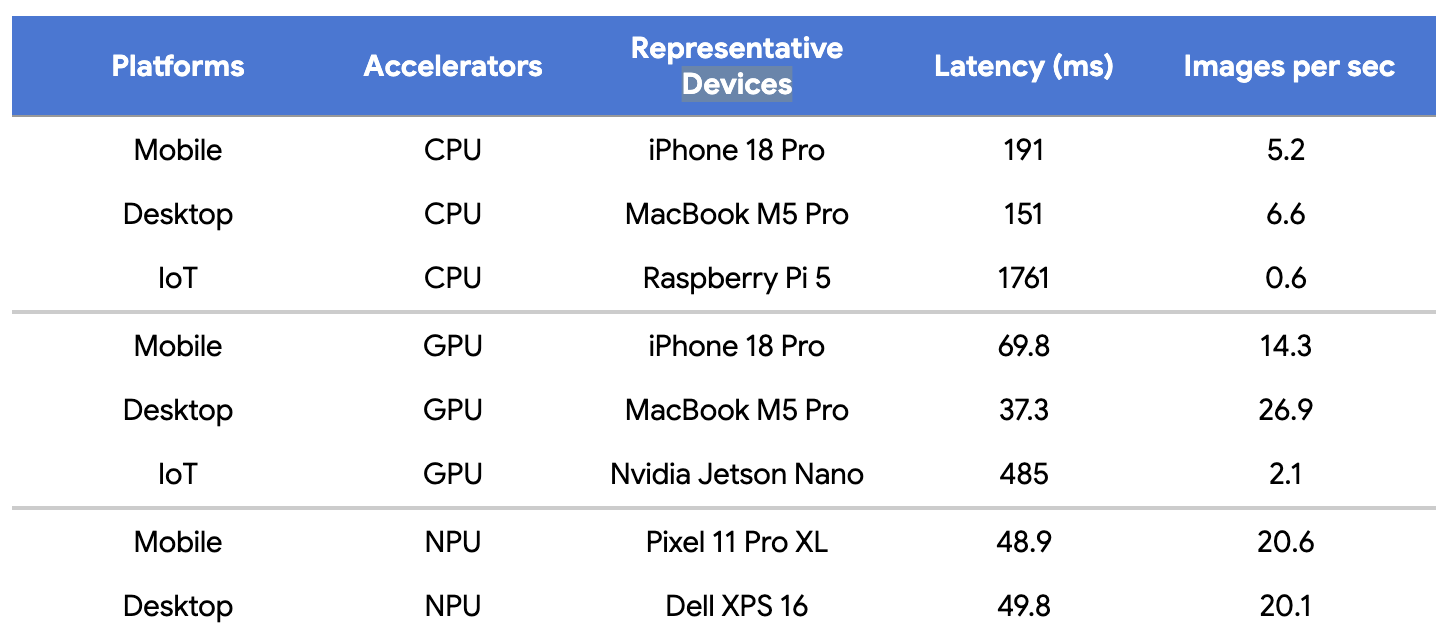
O ponto mais importante para desenvolvedores é o foco em execução local. O Google cita uso de quantização para reduzir o consumo de memória: em um Pixel 11 Pro, o pacote de texto pode exigir cerca de 191 MB de RAM ativa, enquanto a configuração multimodal completa fica em torno de 567 MB. Esses números não significam que qualquer app ficará automaticamente leve, mas indicam que a empresa quer colocar buscas avançadas em produtos que funcionam offline ou com menor latência.
Esse desenho conversa com uma preocupação recorrente no mercado de IA: como usar modelos úteis sem expor documentos, fotos, gravações e histórico pessoal a servidores externos. Se a etapa de busca e recuperação acontece no aparelho, dados sensíveis podem permanecer mais próximos do usuário. Para empresas, isso também pode reduzir tráfego, custo de infraestrutura e riscos de governança, embora cada implementação ainda dependa de políticas próprias de segurança.
Benchmarks e integração com Gemma 4
No anúncio, o Google diz que o EmbeddingGemma 2 lidera entre modelos multimodais abaixo de 1 bilhão de parâmetros em testes como MTEB Code e MAEB, além de igualar ou superar modelos maiores em tarefas de texto, visão e áudio. A cobertura do The Decoder destacou o mesmo ponto: a aposta do Google é competir por eficiência, não apenas por tamanho.
Outro detalhe técnico é a janela de contexto de 8 mil tokens, quatro vezes maior que a do EmbeddingGemma 1, segundo a empresa. O modelo também usa Matryoshka Representation Learning, que permite reduzir vetores de 768 dimensões para 512, 256 ou 128 dimensões. Isso pode diminuir armazenamento em bancos vetoriais locais, um gargalo comum em apps com muitas imagens, áudios ou documentos.
Quando combinado com modelos generativos como o Gemma 4, o EmbeddingGemma 2 pode atuar como a camada de recuperação: ele encontra o material relevante e outro modelo responde, resume ou raciocina sobre o conteúdo. Essa divisão é especialmente útil para agentes de IA que precisam vasculhar arquivos pessoais, repositórios de código ou bibliotecas multimídia. O GalaxyIA publicou recentemente outra notícia sobre modelos em escala, o Mistral Large 4, e o contraste ajuda a entender a tendência: nem toda inovação vem de aumentar o número de parâmetros.
Como desenvolvedores podem testar
Os pesos do EmbeddingGemma 2 estão disponíveis no Hugging Face e no Kaggle. O Google Developers Blog também publicou orientações para uso com Google AI Edge, MediaPipe, LiteRT, WebGPU e ferramentas como Ollama, llama.cpp e Qdrant.
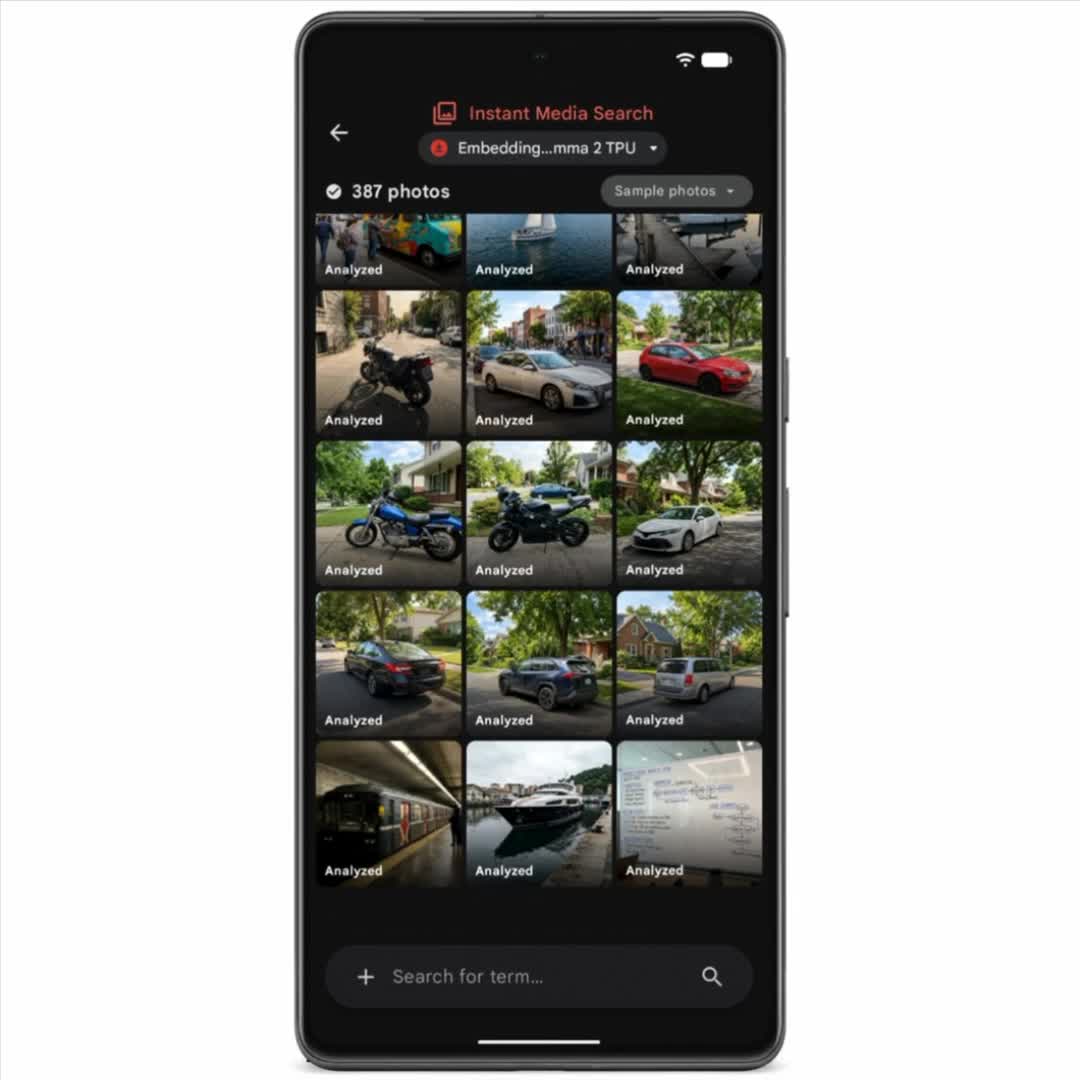
Para o usuário final, o efeito deve aparecer de forma indireta. Apps poderão oferecer busca por significado em galerias, notas, vídeos, documentos e arquivos de áudio, com respostas mais rápidas e menor dependência de conexão. Para desenvolvedores brasileiros, a notícia é relevante porque modelos abertos e eficientes tendem a baixar a barreira de entrada para criar recursos de IA em produtos menores, inclusive sem grande orçamento de nuvem.

Deixe um comentário